VLA-модель (зрение-язык-действие)
Нейросеть, которая принимает изображение с камер и текстовую команду и выдаёт действия робота.
Вместо программирования каждого шага вы говорите роботу что-то вроде положи красную чашку в раковину, а модель сама решает, как двигать суставами. Одна модель может справляться со множеством задач, поэтому VLA сейчас в центре проектов с гуманоидами.
Покупателю стоит помнить, что технология пока ранняя. Демо часто работают в обстановке, где модель обучали, и ломаются на новой кухне. Спрашивайте про процент успеха в незнакомых местах, сколько длится одно действие и работает ли модель на самом роботе или нужен интернет.
Связанные термины
 Китай
Гуманоиды и R&D
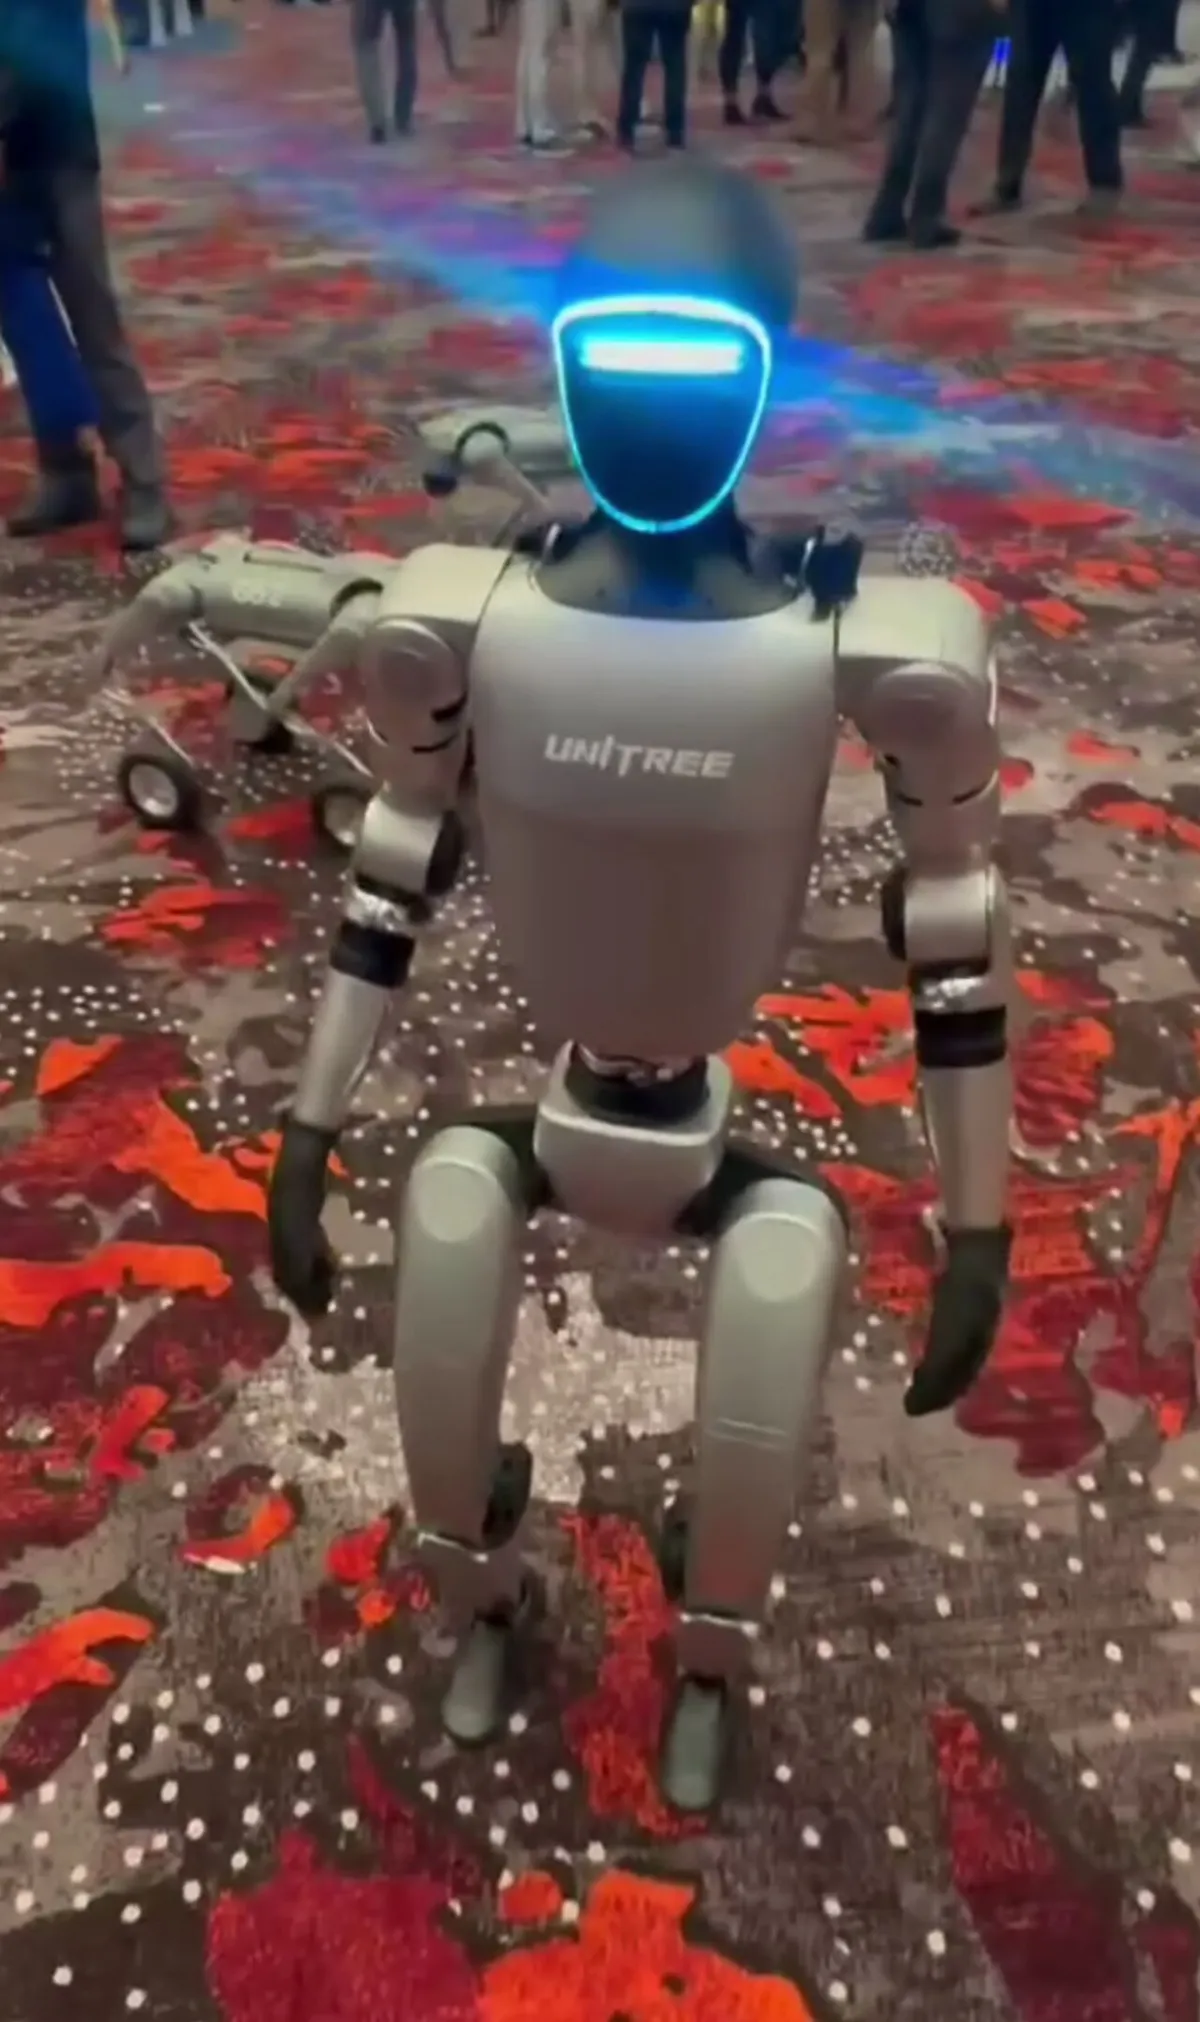
Unitree G1
Двуногий гуманоид
Нагрузка
2 кгРабота
2 чСкорость
7.2 км/ч$13,500 – $16,000цена на сентябрь 2026
В продажеФото скоро
КитайГуманоиды и R&D
Unitree H1
Двуногий гуманоид
Нагрузка
7 кгРабота
нет данныхСкорость
нет данных$90,000цена на сентябрь 2026
Под заказФото скоро
СШАГуманоиды и R&D
Figure 02
Двуногий гуманоид
Нагрузка
20 кгРабота
5 чСкорость
3 км/чНе продаётся, цены нет
Не продаётся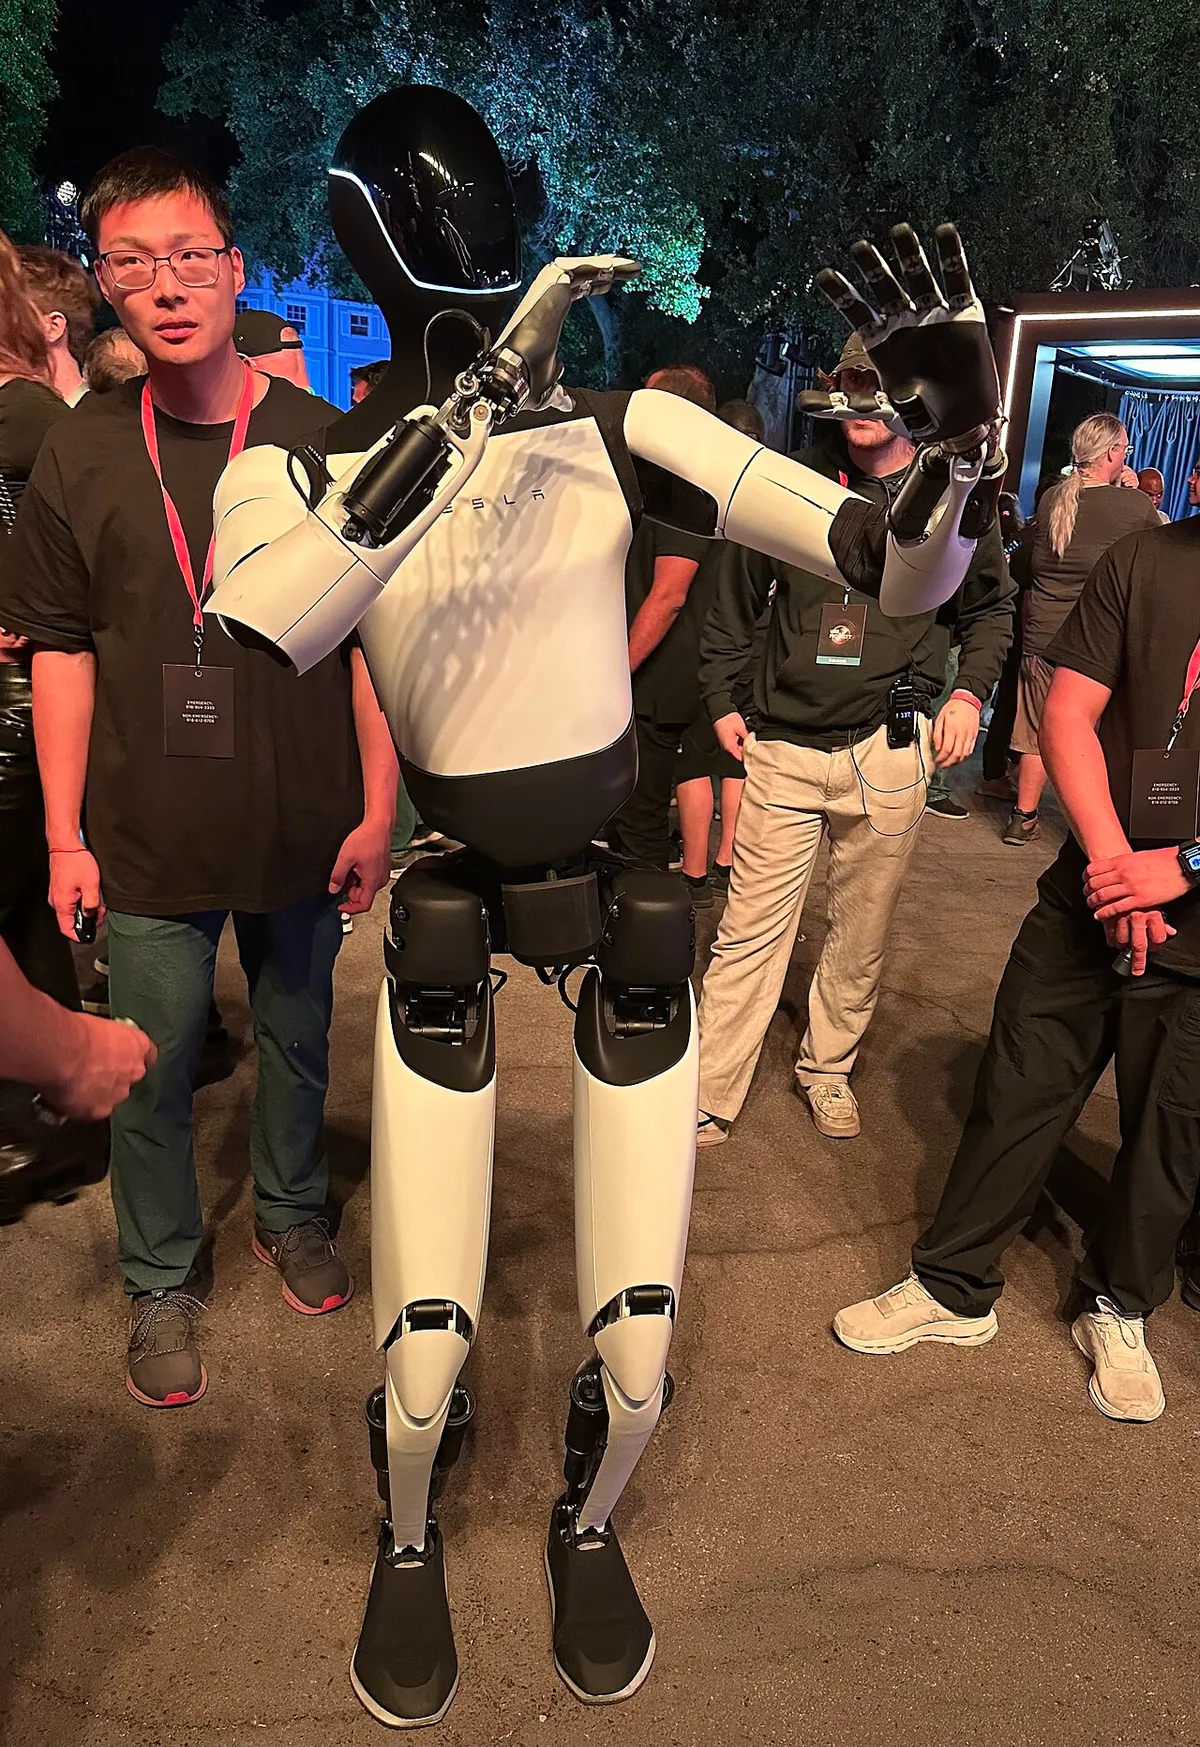 США
Гуманоиды и R&D
Tesla Optimus
Двуногий гуманоид
Нагрузка
нет данныхРабота
нет данныхСкорость
нет данныхНе продаётся, цены нет
Не продаётся