VLA-Modell (Vision-Language-Action)
Ein neuronales Netz, das Kamerabilder und eine Textanweisung aufnimmt und Roboteraktionen ausgibt.
Statt jeden Schritt zu programmieren, sagen Sie dem Roboter etwa stell die rote Tasse in die Spüle, und das Modell entscheidet, wie die Gelenke bewegt werden. Dasselbe Modell kann viele Aufgaben übernehmen, deshalb stehen VLA-Modelle im Zentrum aktueller Humanoid-Projekte.
Für Käufer ist das noch früh. Demos funktionieren oft in der Umgebung, in der trainiert wurde, und scheitern in einer neuen Küche. Fragen Sie nach Erfolgsquoten in unbekannten Räumen, wie lange eine Aktion dauert und ob das Modell auf dem Roboter läuft oder eine Cloud-Verbindung braucht.
Verwandte Begriffe
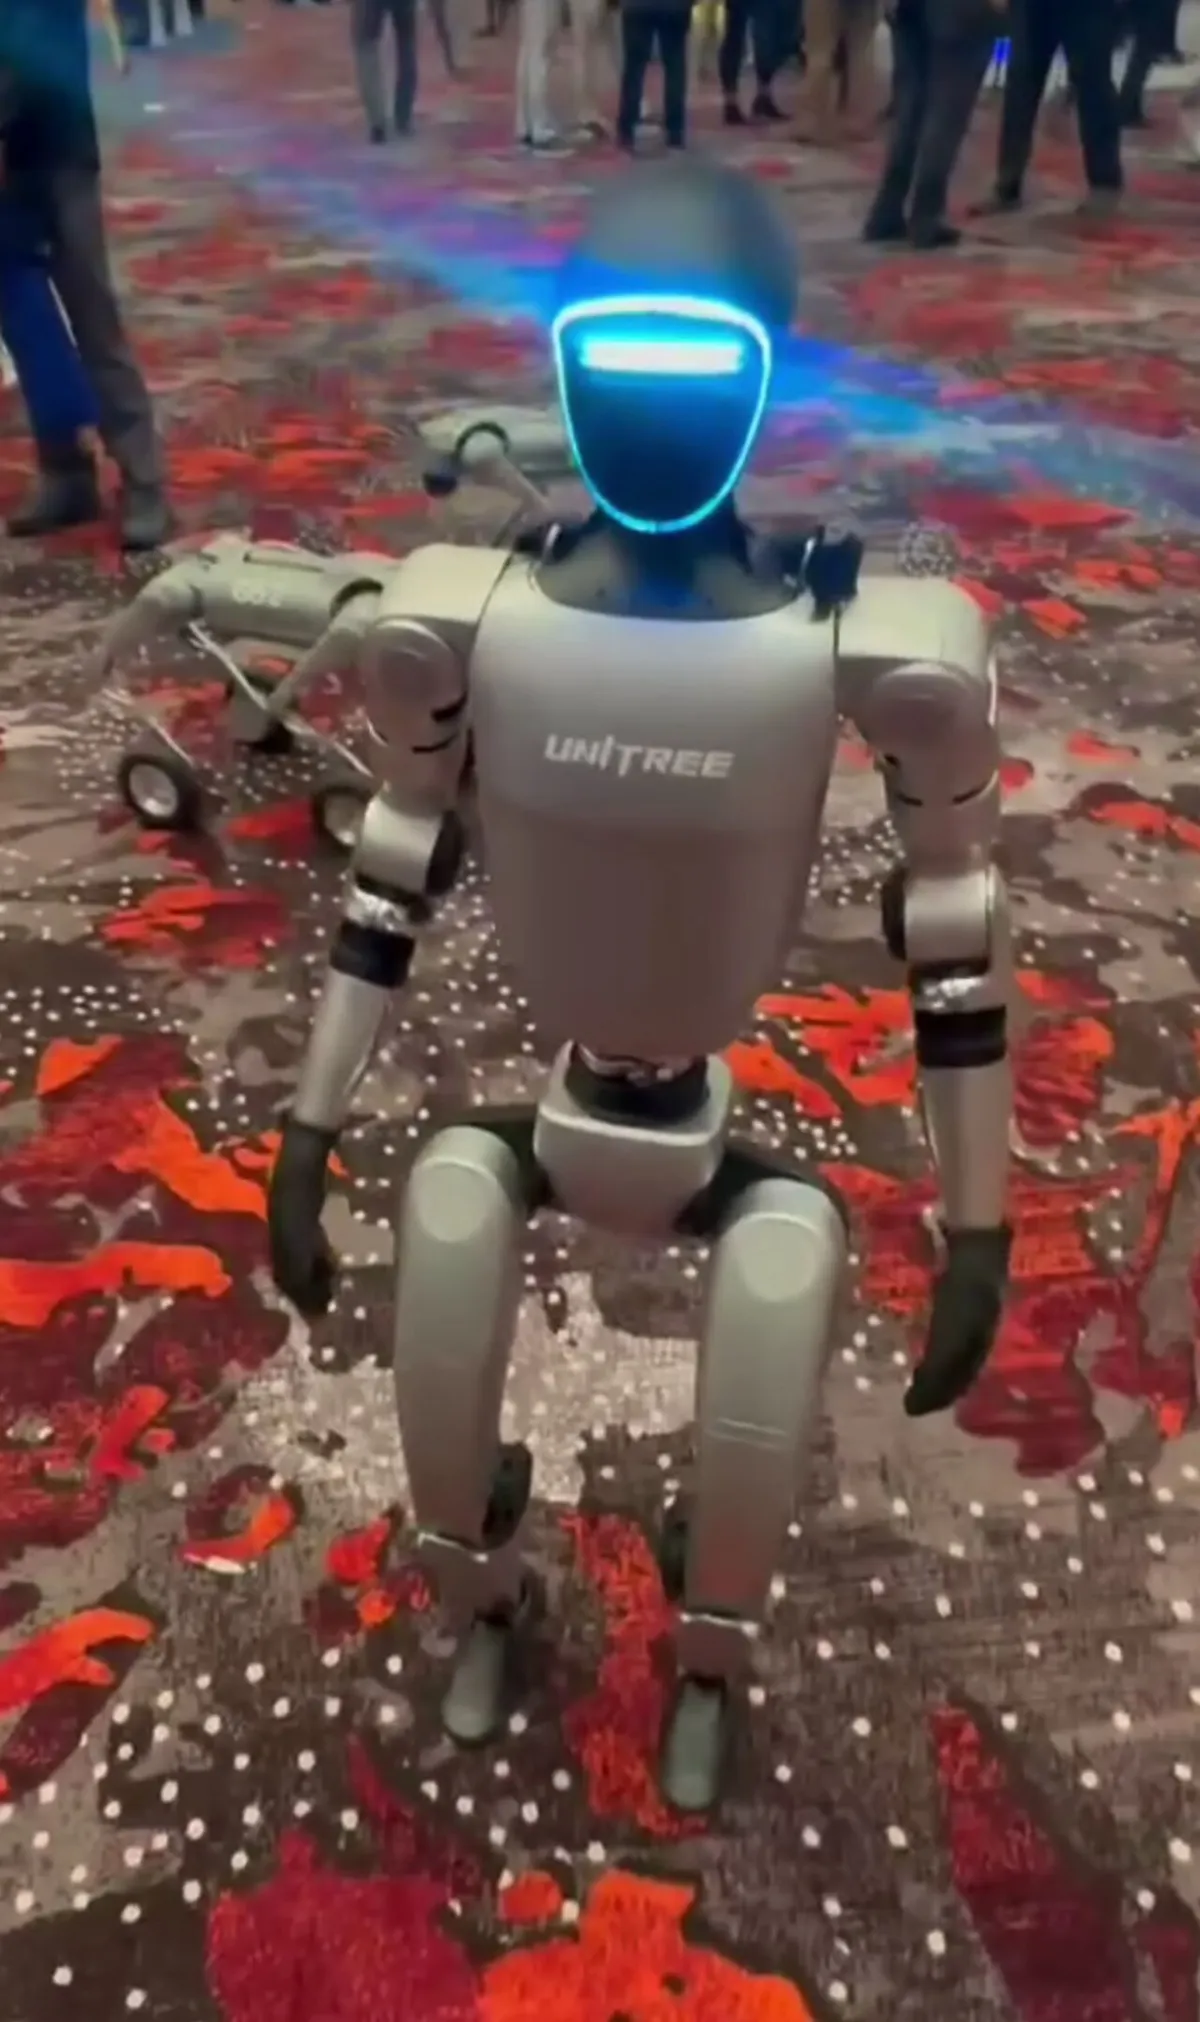 China
Zweibeiniger Humanoider
Zweibeiniger Humanoider
Zweibeiniger Humanoider
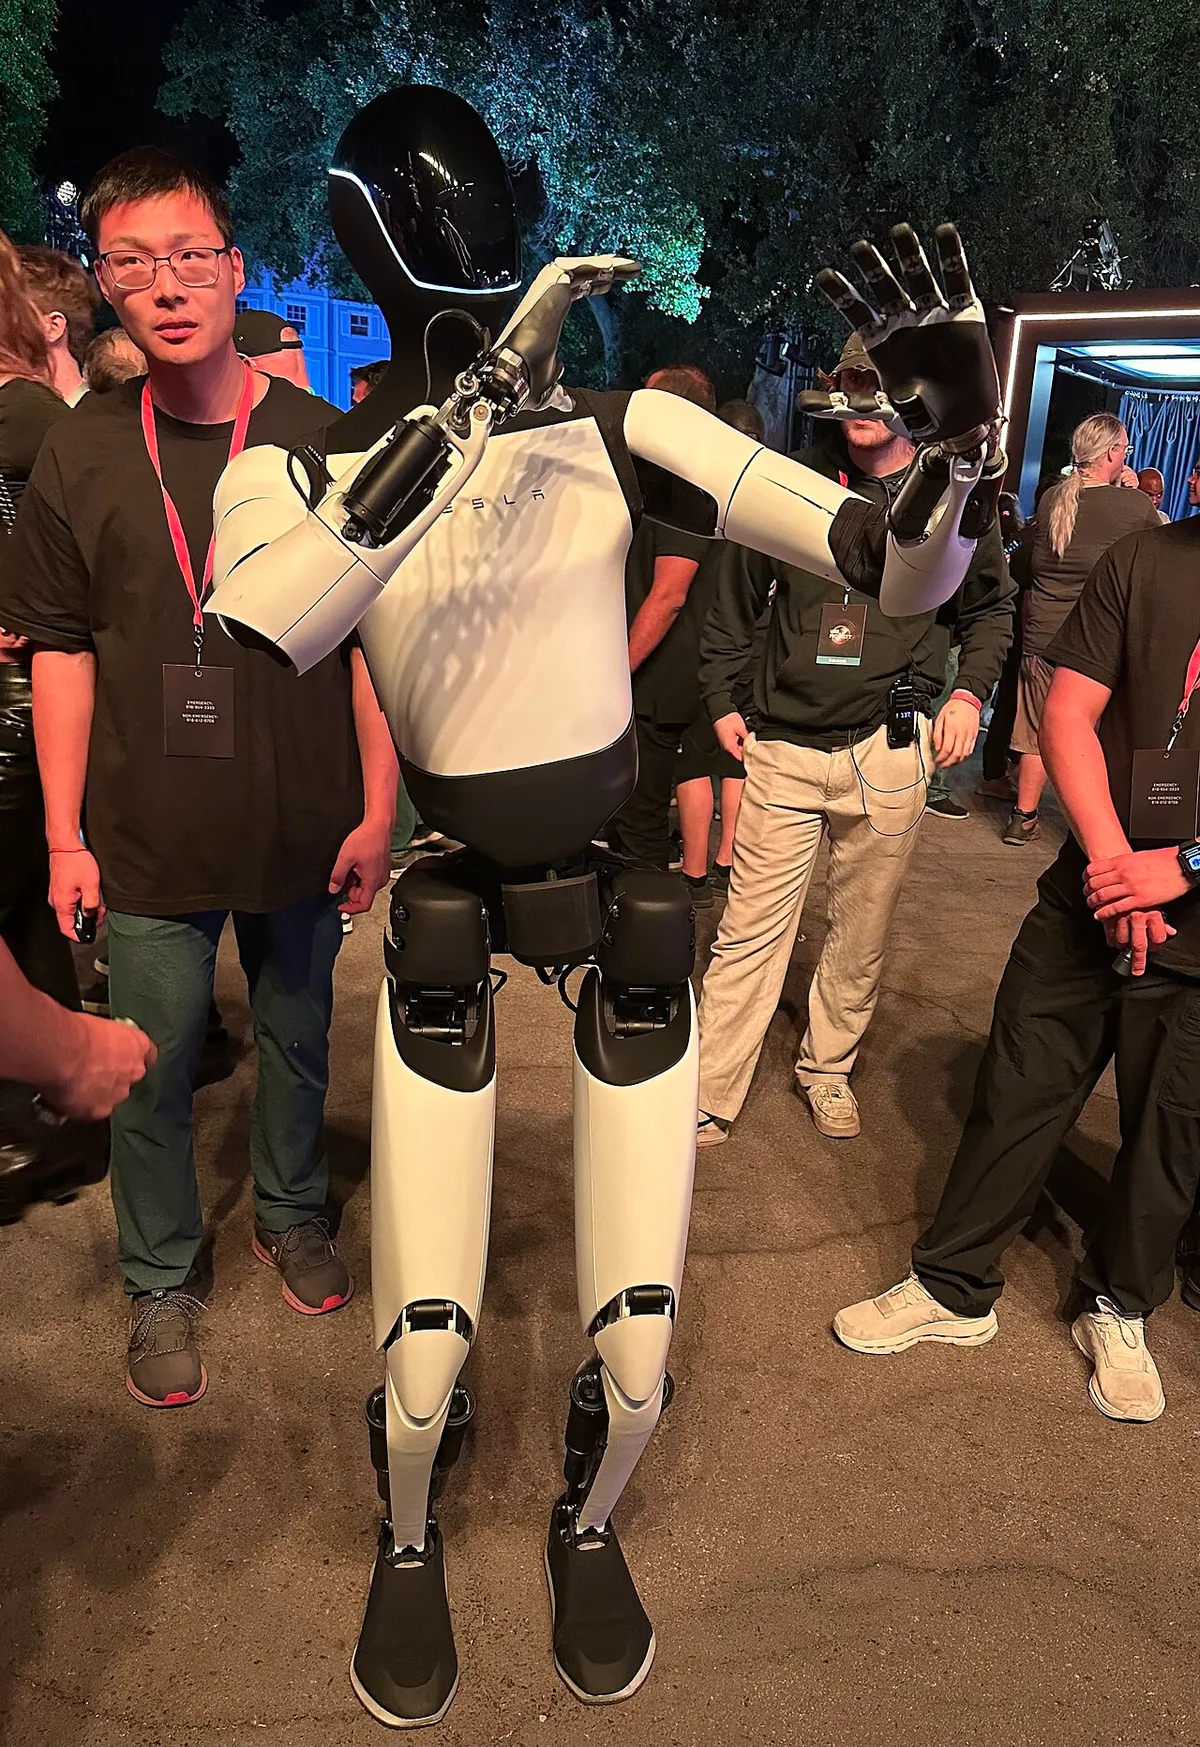 USA
Zweibeiniger Humanoider